
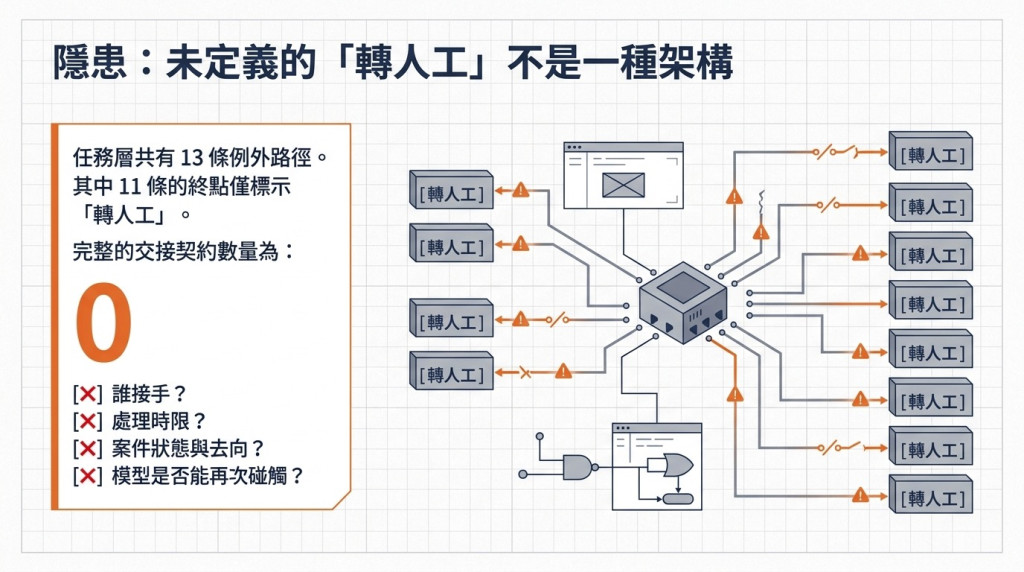
在設計 AI 系統時,開發者往往會陷入一種「成功路徑(Happy Path)」的預設偏執:我們花費無數小時優化 Prompt、微調模型參數,只為了追求那卓越的準確率。然而,現實世界的數據總是充滿惡意——格式崩潰、觸及敏感資訊、或是模型乾脆陷入幻覺。當這些情況發生時,系統往往會陷入一種混亂的沈默,或是更糟地,給出一個似是而非的錯誤結果。
一個 AI 系統的成熟度,不在於它表現得有多聰明,而在於它在失敗時「姿態是否優雅」。作為研發領袖,我始終堅持「負責任的 AI 開發」不應只是簡報上的口號,而必須落實在程式碼的細節中。我們需要一套鋼鐵般堅固的機制,確保當 AI 罷工時,系統能安全地將任務移交給人類。
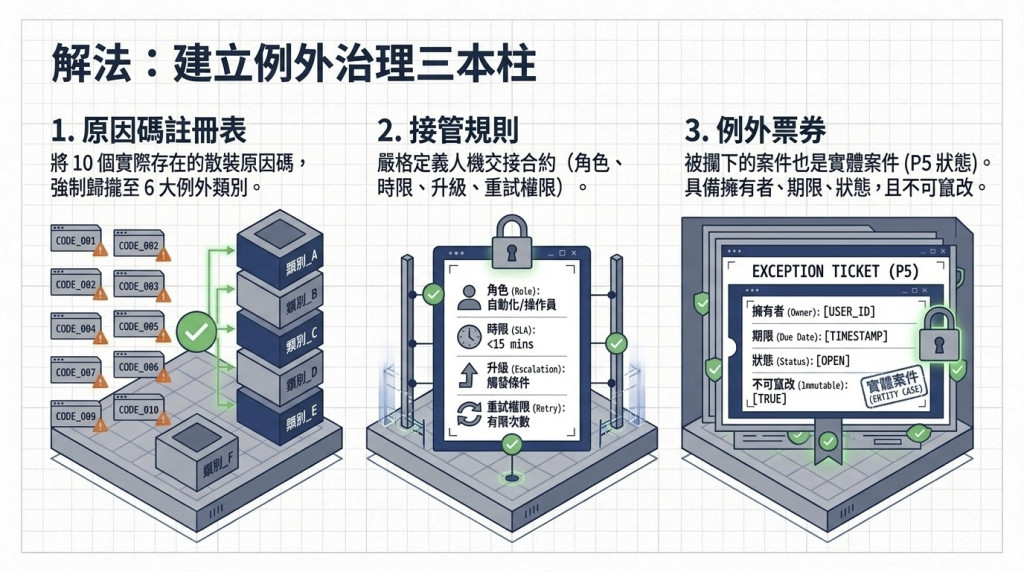
在傳統軟體工程中,我們習慣將「報錯」視為系統失靈。但在 AI 治理的邏輯裡,我們必須嚴格區分「例外(Exception)」與「失敗(Failure)」。當 AI 因為偵測到「敏感輸入」或「找不到事實依據」而停止運作時,這並非系統崩潰,而是系統正在履行它的治理職責。
如果將這些情況與「資料庫斷線」等系統失敗混為一談,會導致案件狀態的管理失控。在我們的架構中,除了「系統失敗」會將案件轉為 Failed 外,其餘如資料不足、格式錯誤等例外,案件皆應停留在 Processing(處理中)狀態。這種分流邏輯確保了案件不會在系統出錯時無端消失,並透過生成一張「例外票券(ExceptionTicket)」來確保人工接管的連續性。
> 「例外票券被攔下的案件也是案件,它必須擁有明確的主人、期限與狀態,且具備不可變性,確保治理過程留痕。」
在實作票券結案功能 resolve_ticket 時,我曾遇到一個極具啟發性的失敗案例。當時我的直覺設計是:當一個因為服務短暫斷線(SERVICE_DOWN)而進入 Failed 狀態的案件,在服務恢復後,應該由系統自動將它轉回 Processing。這看起來是個體貼的自動化設計,對吧?
然而,測試直接噴出了 app.models.case.TransitionError。原來,我在 Day 12 建立的狀態機早已焊死了這條路徑:從 Failed 轉回 Processing 被定義為人工判斷點,僅限「人」來觸發。當我的程式試圖以 actor_type=system 的身分跨越這條紅線時,系統果斷拒絕。
這正是軟體架構中最具價值的時刻:「今天的我想開便利後門,昨天的我把它焊死了。」
如果這條紅線只寫在文件上,自動化重啟就會安靜地上線。某天服務閃斷後,一批本該人工確認的風險案件就會在沒有監督的情況下自行復活。將責任歸屬寫進程式碼,強制決策必須由人做出並「簽名留痕」,是防止 AI 系統失控的最後防線。
在處理 AI 例外時,我們必須遵循「錯誤代價不對稱原則」。在我們的「原因碼註冊表」中,總共定義了 10 個核心原因碼,歸類為六大類(資料不足、無法分類、格式錯誤、高敏感資料、找不到依據、系統失敗)。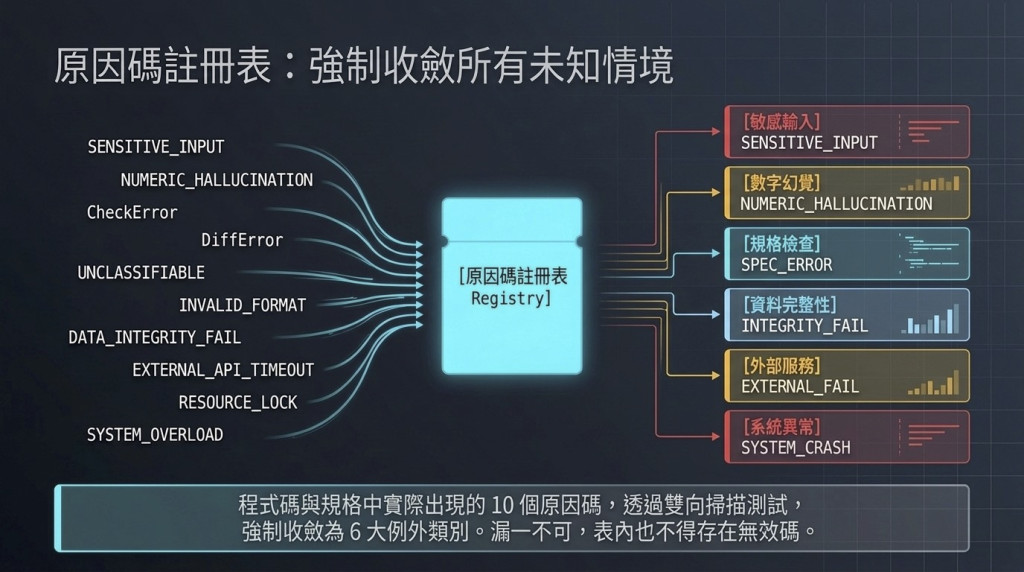
其中針對「找不到依據(NO_CLAUSES)」的處理最為果斷:系統規定不再送交模型重試。為什麼?因為在流程中,系統通常已經給過模型修正的機會(例如附帶違規清單的重試),若第二次嘗試依然失敗,代表該模型在此特定輸入上是不可靠的。此時若繼續自動重試,本質上是在「擲骰子」,期望下一次模型能走運吐出正確答案。在嚴肅的金融或法律業務中,這種不確定性是不可接受的,果斷轉人工撰寫才是最有效率且安全的作法。
針對「高敏感資料」這一類別,我們體現了對資料隱私與法規的敬畏,給予這類案件最嚴苛的「特權待遇」:
透過這些沉重的合規契約,我們確保了在高風險區域,人類的判斷力永遠優先於算法,且過程中的每一步都有明確的責任人。
在 Day 13 的實作中,我們最核心的貢獻是建立了一套「原因碼註冊表」與「雙向掃描機制」。這套機制會自動掃描程式碼與規格書,確保每一組出現的錯誤碼都已註冊,且註冊表中的代碼在程式中確實存在。這種「治理邏輯與程式碼同步」的設計,徹底終結了以往原因碼隨意散落、無法追蹤的亂象。
現在,每一條例外路徑都必須帶齊「交接契約五要件」:
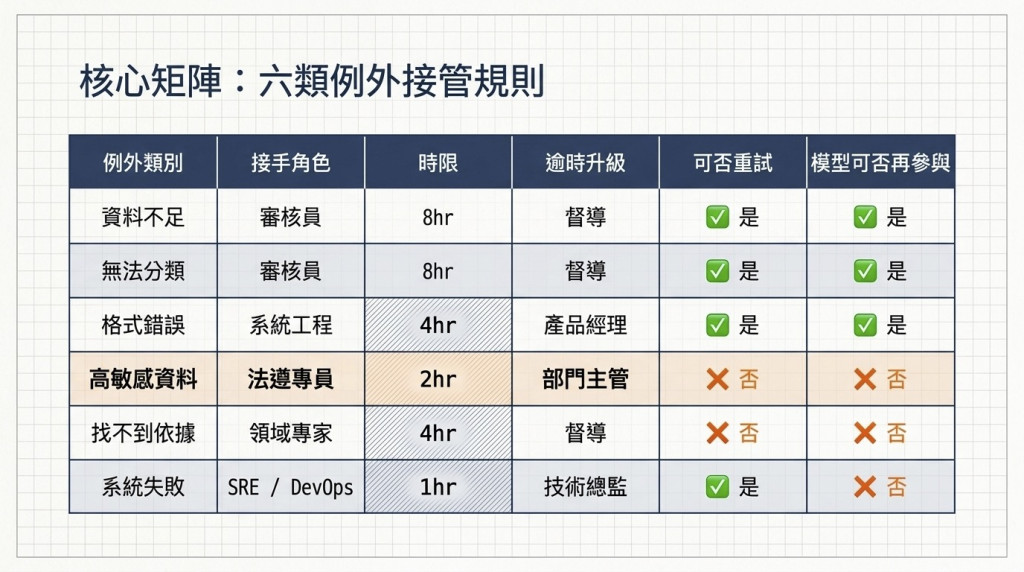
當 105 項測試全數通過(105 passed)時,那種安心感並非來自「程式不再出錯」,而是來自「我知道當它出錯時,它會如何優雅地交棒」。
在你的 AI 專案中,不妨也反思一下:當 AI 產出的結果不可信時,你的系統是會安靜地走入歧途,還是會大聲地向人類呼救?結清這些關於「失敗」的技術債,是為了讓我們在 AI 規模化應用的道路上,跑得更穩、更遠。


 iThome鐵人賽
 看影片追技術